


Vyhľadávací pavúk
Vyhľadávací pavúk je automatizovaný bot, ktorý prehľadáva webové stránky a indexuje obsah pre vyhľadávače ako Google a Bing. Zistite, ako fungujú.
10 min čítania
SEO
DigitalMarketing
+3
Prehľadávač vyhľadávačov je automatizovaný softvérový program – nazývaný aj bot, spider alebo spiderbot – ktorý systematicky prehľadáva World Wide Web, sťahuje obsah stránok a sleduje hypertextové odkazy s cieľom objaviť nové alebo aktualizované URL adresy.
Prehľadávač vyhľadávačov je automatizovaný softvérový program – nazývaný aj bot, spider alebo spiderbot – ktorý systematicky prehľadáva World Wide Web, sťahuje obsah stránok a sleduje hypertextové odkazy s cieľom objaviť nové alebo aktualizované URL adresy. Jeho hlavnou úlohou je dodávať indexu vyhľadávača čerstvé údaje, aby keď niekto zadá dotaz, vyhľadávač mohol vrátiť relevantné a aktuálne výsledky. Bez prehľadávačov by vyhľadávač nemal spôsob, ako zistiť, že stránka vôbec existuje.
Samotný prehľadávač nič nehodnotí. Objavuje a odovzdáva to, čo nájde – text, odkazy, metadáta, obrázky – samostatnému systému indexovania a hodnotenia. Prehľadávanie, indexovanie a hodnotenie sú tri odlišné fázy. Stránka môže byť prehľadaná a napriek tomu sa nikdy neobjaviť vo výsledkoch vyhľadávania, ak počas indexovania nespĺňa kvalitatívne prahy vyhľadávača.
Dokumentácia prehľadávačov Google rozlišuje medzi bežnými prehľadávačmi, špeciálnymi prehľadávačmi a používateľom spúšťanými získavačmi. Pri skúmaní problémov s prístupom si overte zdokumentovanú identitu a správanie príslušného prehľadávača.
Na tejto stránke
Webový prehľadávač pracuje v nepretržitej slučke postavenej na niekoľkých kľúčových krokoch. Pochopenie týchto krokov pomáha vlastníkom webových stránok diagnostikovať, prečo sa stránky nemusia zobrazovať vo výsledkoch vyhľadávania – problém je často už v štádiu prehľadávania, dávno predtým, než sa vôbec uvažuje o hodnotení.
Každý prehľadávač začína so sadou známych URL adries nazývaných seed URL. Tie môžu pochádzať z predtým prehľadaných stránok, odoslaných sitemap alebo ručne vybraných východiskových bodov. Prehľadávač stiahne každú seed stránku, extrahuje všetky hypertextové odkazy, ktoré nájde, a každý doteraz nevidený odkaz pridá do fronty nazývanej crawl frontier.
Cyklus sa potom opakuje:
Táto slučka v podstate nikdy nekončí. Web sa neustále mení a každú sekundu pribúdajú nové stránky, takže prehľadávač jednoducho spracúva to, čo je práve vo fronte, pričom znovu navštevuje staré stránky, aby skontroloval zmeny, a pridáva novoobjavené URL adresy.
Keď prehľadávač načíta stránku, vykreslí jej obsah – prečíta HTML, kde je to možné, spustí JavaScript a extrahuje text, obrázky, metadáta a štruktúrované údaje. Potom tieto informácie stiahne a odošle ich indexovaciemu systému vyhľadávača.
Nie každý prehľadávač spracúva JavaScript rovnako dobre. Googlebot vykresľuje JavaScript a čaká na dynamicky načítaný obsah, no menšie prehľadávače vyhľadávačov môžu čítať iba statické HTML. To je dôvod, prečo môžu byť stránky postavené výhradne na klientskych JavaScript frameworkoch pre niektoré vyhľadávače neviditeľné, pokiaľ nie je zavedené serverové vykresľovanie.
Prehľadávače objavujú nové stránky prostredníctvom dvoch hlavných kanálov:

Nastavte pokročilé sledovanie za pár minút. Kreditná karta nie je potrebná.
Prehľadávače nezaobchádzajú so všetkými stránkami rovnako. Pracujú podľa súboru politík prehľadávania, ktoré určujú, ktoré stránky navštíviť, v akom poradí a ako často sa vracať.
Prehľadávač musí rozhodnúť, ktoré URL adresy uprednostniť zo svojho crawl frontier. Bežné signály zahŕňajú:
Ako často sa prehľadávač vráti na stránku, závisí od toho, ako často sa stránka mení. Titulná stránka spravodajského webu môže byť prehľadávaná každých pár minút. Statická stránka „O nás“ môže byť znovu navštívená raz za niekoľko mesiacov. Správcovia webov môžu signalizovať frekvenciu zmien pomocou značiek <changefreq> v XML sitemap, hoci vyhľadávače ich považujú skôr za náznaky než za príkazy.
Prehľadávače sú naprogramované tak, aby nezahlcovali webové servery. Rešpektujú limit rýchlosti prehľadávania – maximálny počet požiadaviek, ktoré odošlú na jednu stránku v danom časovom období. Ak server odpovedá HTTP chybami ako 500 alebo 503, prehľadávač ustúpi, aby problém ešte nezhoršil. Toto je súčasť toho, prečo je prehľadávanie vo veľkom meradle skutočným technickým výzvou.
Súbor robots.txt je textový dokument umiestnený v koreňovom adresári domény, ktorý hovorí prehľadávačom, ktoré URL adresy môžu a ktoré nesmú požadovať. Je to najdôležitejší nástroj na správu prístupu prehľadávačov. Záznam v robots.txt môže vyzerať takto:
User-agent: Googlebot
Disallow: /private/
Allow: /public/
/private/, ale povoľuje všetko pod /public/. Ostatné prehľadávače kontrolujú rovnaký súbor a riadia sa vlastnými direktívami User-agent. Stojí za zmienku, že robots.txt je dobrovoľný protokol – dobre vychované prehľadávače ho dodržiavajú, ale škodlivé boty ho môžu úplne ignorovať.Crawl budget je počet stránok, ktoré vyhľadávač prehľadá na webe v danom časovom období. Určujú ho dva faktory:
Pri malých stránkach je crawl budget zriedka problémom. Pri veľkých e-commerce platformách alebo obsahových weboch s miliónmi URL adries sa správa crawl budget stáva nevyhnutnou – plytvanie prehľadávaním na duplicitný obsah, parametre facetovej navigácie alebo nízko hodnotné stránky znamená menej prostriedkov na stránky, ktoré sú skutočne dôležité.
Každý významný vyhľadávač prevádzkuje vlastný prehľadávač s jedinečným reťazcom user-agent – identifikátorom, ktorý bot posiela s každou HTTP požiadavkou, aby servery vedeli, ktorý prehľadávač ich navštevuje.
| Vyhľadávač | Názov prehľadávača | Identifikátor User-Agent | Účel |
|---|---|---|---|
| Googlebot | Googlebot/2.1 | Prehľadáva a indexuje webové stránky pre Google Search a ďalšie služby Google | |
| Bing | Bingbot | Mozilla/5.0 (compatible; bingbot/2.0) | Prehľadáva a indexuje stránky pre Microsoft Bing |
| DuckDuckGo | DuckDuckBot | DuckDuckBot/1.0 | Prehľadáva stránky pre výsledky vyhľadávania DuckDuckGo |
| Yandex | YandexBot | Mozilla/5.0 (compatible; YandexBot/3.0) | Prehľadáva stránky pre Yandex Search (dominantný v Rusku) |
| Baidu | Baiduspider | Mozilla/5.0 (compatible; Baiduspider/2.0) | Prehľadáva stránky pre Baidu Search (dominantný v Číne) |
| Apple | Applebot | Applebot/1.0 | Prehľadáva stránky pre Spotlight Search a návrhy Siri |
Google tiež prevádzkuje špecializované prehľadávače pre rôzne typy obsahu – Googlebot Image prehľadáva obrázky, Googlebot Video spracúva video obsah, Googlebot News sa zameriava na spravodajské články a AdsBot kontroluje kvalitu vstupných stránok pre Google Ads.
Buďte prvý, kto sa dozvie o nových funkciách a aktualizáciách produktu.
Identifikácia, či je návštevník skutočne Googlebot, si vyžaduje viac než len kontrolu reťazca user-agent, pretože tieto reťazce môžu byť sfalšované. Na overenie prehľadávača Google:
Googlebot.googlebot.com alebo google.com.Google poskytuje oficiálnu dokumentáciu uvádzajúcu svoje IP rozsahy na google.com/bot.html. Každý návštevník, ktorý tvrdí, že je Googlebot, a neprejde týmito overovacími krokmi, je falšovaný bot a mal by byť považovaný za podozrivého.
Áno – ale s obmedzeniami. Hlavné vyhľadávače prevádzkujú vyhradené prehľadávače pre ne-textový obsah:
VideoObject, aby pochopil názov, popis, náhľad a dĺžku.Prehľadávače však nedokážu „vidieť“ obrázky tak, ako ich vidí človek, ani „sledovať“ video. Spoliehajú sa výlučne na textové signály – názvy súborov, alt atribúty, popisky, okolitý text tela a štruktúrované údaje – na určenie relevantnosti. Obsah uzamknutý za prihlasovacími bránami, paywallmi alebo vložený do komplexných JavaScript prehrávačov nemusí byť vôbec prehľadaný.
Tieto pojmy sa často používajú zameniteľne, ale opisujú odlišné veci:
| Aspekt | Webový prehľadávač | Webový scraper |
|---|---|---|
| Účel | Objavuje a indexuje URL adresy na celom webe | Extrahuje konkrétne údaje z cielených stránok |
| Rozsah | Široký – sleduje odkazy všade | Úzky – zameriava sa na známe URL adresy alebo domény |
| Výstup | Napája vyhľadávací index | Produkuje štruktúrované údaje (CSV, databáza, tabuľka) |
| Typický prevádzkovateľ | Vyhľadávače (Google, Bing) | Podniky, výskumníci, dátoví analytici |
| Rešpektuje robots.txt | Áno (legitímne prehľadávače) | Rôzne – mnohé scrapery ho ignorujú |
| Príklady | Googlebot, Bingbot | Nástroje na monitorovanie cien, scrapery na generovanie leadov, zberače tréningových dát pre AI |
Vyhľadávače nachádzajú nové stránky prostredníctvom niekoľkých kanálov:
Najrýchlejšia cesta k prehľadaniu novej stránky je odoslanie jej URL adresy priamo cez Search Console a zabezpečenie, že je odkazovaná z už indexovanej stránky na rovnakej doméne.
Neexistuje žiadny pevný harmonogram. Frekvencia opätovných návštev závisí od:
Vlastníci stránok môžu ovplyvniť frekvenciu opätovných návštev pravidelným publikovaním obsahu, udržiavaním rýchlych odoziev servera a odosielaním aktualizovaných sitemap. V konečnom dôsledku si však prehľadávač určuje svoj vlastný harmonogram na základe signálov, ktoré pozoruje.
Prehľadávače vo všeobecnosti nemôžu pristupovať k:
Prehľadávač vidí len to, čo je verejne prístupné a odkazované. Ak stránka vyžaduje na vykreslenie autentifikáciu alebo interakciu používateľa, je pre vyhľadávače v podstate neviditeľná – pokiaľ jej vlastník výslovne neudelí prístup alebo neposkytne alternatívnu cestu, napríklad sitemap obsahujúci URL adresu v kombinácii so štruktúrovanými údajmi, ktoré opisujú obsah.
Vytvoriť prehľadávač, ktorý funguje pre niekoľko stoviek stránok, je jednoduché. Vytvoriť taký, ktorý funguje pre miliardy, je úplne iný problém. Bežné body zlyhania zahŕňajú:
Pre väčšinu podnikov nie je prevádzkovanie rozsiahleho webového prehľadávača praktické bez spravovanej infraštruktúry. Rozhodnutie sa zvyčajne scvrkáva na používanie existujúceho nástroja namiesto vytvárania vlastného od nuly.
V Spojených štátoch je webové prehľadávanie verejne prístupných stránok vo všeobecnosti legálne. Viacero súdnych rozhodnutí – vrátane hiQ Labs v. LinkedIn – potvrdilo, že prehľadávanie verejne dostupných údajov neporušuje zákon.
Legálnosť však závisí od niekoľkých faktorov:
Rozdiel medzi prehľadávaním na účely indexovania vyhľadávačov (všeobecne akceptované) a scrapovaním na komerčný zber údajov (právne sporné) je dôležitý. Väčšina legitímnych prehľadávačov vyhľadávačov pôsobí v jasne legálnej oblasti.
Nie – samotný ChatGPT nie je webový prehľadávač. ChatGPT je konverzačný AI model, ktorý generuje odpovede. OpenAI však prevádzkuje samostatný webový prehľadávač nazvaný GPTBot, ktorý prehľadáva verejné webové stránky na zber tréningových dát pre AI modely a na podporu funkcií živého vyhľadávania v niektorých produktoch OpenAI.
GPTBot sa identifikuje pomocou tokenu user-agent GPTBot a rešpektuje direktívy robots.txt. Vlastníci stránok, ktorí chcú zablokovať konkrétne GPTBot, môžu do svojho súboru robots.txt pridať nasledovné:
User-agent: GPTBot
Disallow: /
Prehľadávače vyhľadávačov priamo ovplyvňujú každého v ekosystéme affiliate marketingu. Ak stránka nie je prehľadaná, neumiestni sa vo výsledkoch, a ak sa neumiestni, negeneruje žiadnu organickú návštevnosť – a teda ani affiliate príjmy.
Obsahová stránka publishera stojí alebo padá na prehľadávateľnosti. Každá produktová recenzia, porovnávacia príručka alebo sumár ponúk musí byť objaviteľná pre prehľadávače. Bežné chyby publisherov, ktoré blokujú prehľadávanie, zahŕňajú:
Publishere by mali overiť, že ich najhodnotnejšie stránky sa nachádzajú v správe o pokrytí indexu v Google Search Console a že im nebránia žiadne noindex značky alebo pravidlá robots.txt.
Inzerent prevádzkujúci affiliate program potrebuje, aby boli jeho produktové stránky prehľadané a indexované, aby sa na ne publisheri mohli odkazovať – na živé, viditeľné stránky. Ak produktové stránky obchodníka nie sú v indexe Google, publisheri nemajú kam posielať návštevnosť. Konkrétne riziká zahŕňajú:
Obchodníci by mali udržiavať čisté štruktúry URL, odosielať produktové sitemapy a monitorovať štatistiky prehľadávania v Search Console, aby odhalili problémy skôr, než ovplyvnia partnerských publisherov.
Programoví manažéri stoja medzi obchodníkmi a publishermi a mali by rozumieť správaniu prehľadávačov, aby mohli riešiť problémy s viditeľnosťou. Keď publisher hlási, že produktová stránka obchodníka „sa nezobrazuje v Google“, problém je často v prehľadávaní alebo indexovaní – nie v hodnotení. Praktické kroky zahŕňajú:
site: od Google.Programový manažér, ktorý dokáže diagnostikovať základné problémy s prehľadávaním, prináša priamu hodnotu obom stranám affiliate vzťahu – pomáha obchodníkom opraviť technické problémy a pomáha publisherom potvrdiť, že stránky, ktoré propagujú, sú dohľadateľné.
Zistite, ako vám pochopenie a optimalizácia pre prehľadávače môže zvýšiť viditeľnosť vašej webovej stránky a jej hodnotenie vo vyhľadávačoch.
Vyhľadávací pavúk je automatizovaný bot, ktorý prehľadáva webové stránky a indexuje obsah pre vyhľadávače ako Google a Bing. Zistite, ako fungujú.
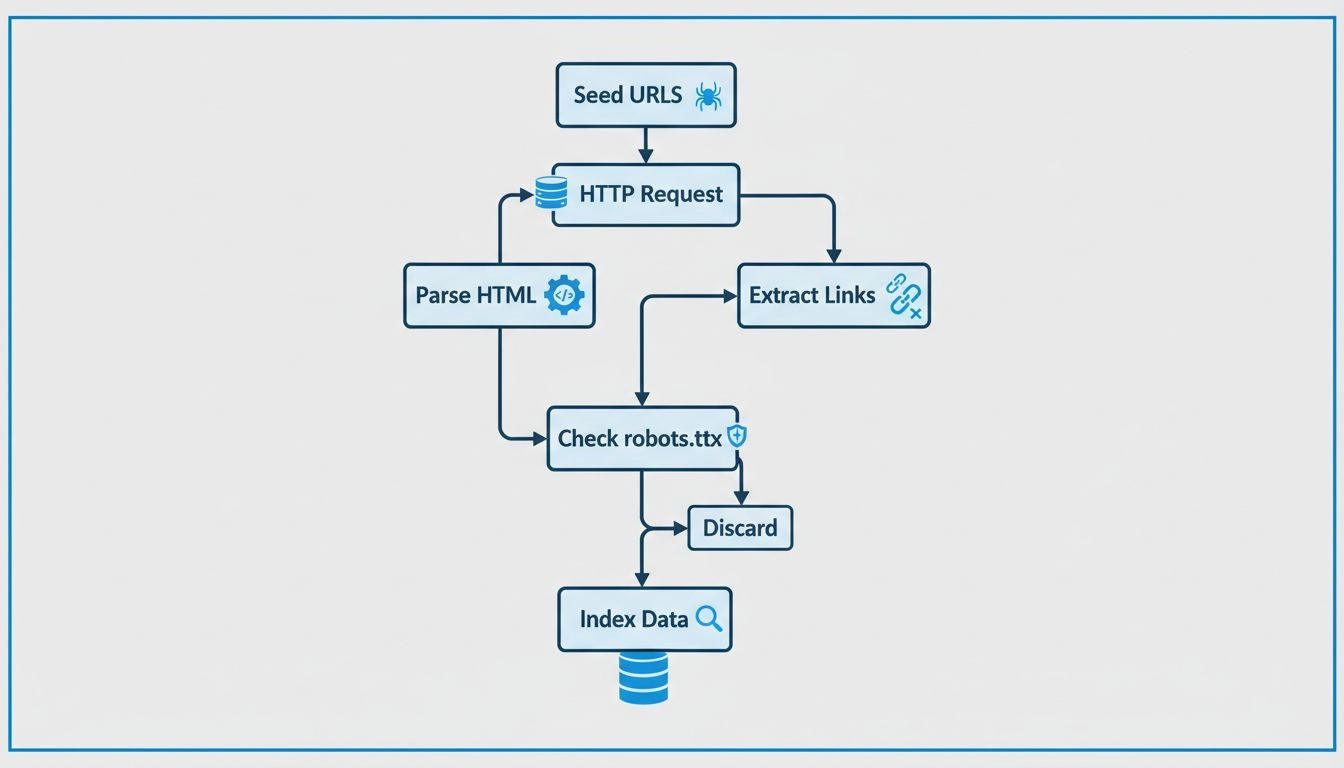
Zistite, ako fungujú webové prehľadávače – od počiatočných URL adries až po indexovanie. Pochopte technický proces, typy prehľadávačov, pravidlá robots.txt a vp...
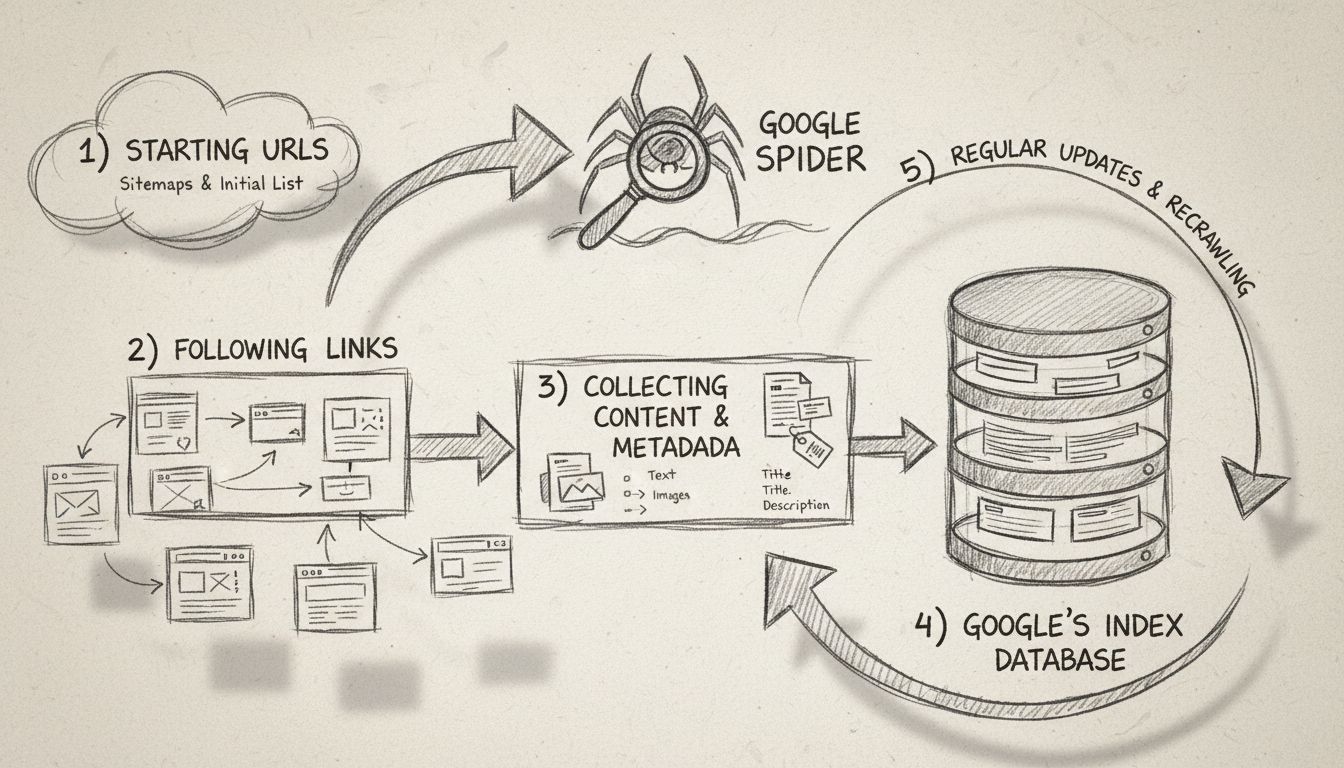
Zistite, čo je Google Spider (Googlebot), ako prehľadáva a indexuje webové stránky a prečo je dôležitý pre SEO. Objavte, ako optimalizovať svoj web pre lepšie p...
Pridajte sa k našej komunite spokojných klientov a poskytujte vynikajúcu zákaznícku podporu s Post Affiliate Pro.


Súhlas s cookies
Používame cookies na vylepšenie vášho prehliadania a analýzu našej návštevnosti. See our privacy policy.