


Prehľadávač vyhľadávačov
Zistite, ako prehľadávače vyhľadávačov objavujú a indexujú webové stránky a prečo je to dôležité pre SEO.
13 min čítania
SEO
Crawlers
+4
Vyhľadávací pavúk je automatizovaný program — nazývaný aj webový crawler, spider bot alebo jednoducho bot — ktorý systematicky prehľadáva World Wide Web, aby objavoval, čítal a zhromažďoval informácie z webových stránok.
Dokumentácia Google pre crawler-y vysvetľuje kategórie crawlerov a fetcherov používané spoločnosťou Google. Použite túto dokumentáciu, keď potrebujete zistiť, ako konkrétny Google crawler pristupuje k affiliate webovej stránke.
Na tejto stránke
Vyhľadávací pavúk je automatizovaný program — nazývaný aj webový crawler, spider bot alebo jednoducho bot — ktorý systematicky prehľadáva World Wide Web, aby objavoval, čítal a zhromažďoval informácie z webových stránok. Dáta, ktoré pavúk zhromaždí, sú odoslané späť vyhľadávaču, ktorý ich usporiada do obrovskej databázy nazývanej index. Keď niekto zadá vyhľadávací dopyt, vyhľadávač vytiahne relevantné výsledky z tohto indexu, nie z živého webu.
Termín “pavúk” pochádza zo spôsobu, akým tieto programy navigujú web: sledujú hypertextové odkazy zo stránky na stránku, podobne ako pavúk sa pohybuje po vláknach svojej siete. Prvým známym crawlerom bol WebCrawler, spustený v roku 1994, ktorý pomohol spopularizovať túto metaforu.
Vyhľadávací pavúk je automatizovaný program — nazývaný aj webový crawler, spider bot alebo jednoducho bot — ktorý systematicky prehľadáva World Wide Web, aby objavoval, čítal a zhromažďoval informácie z webových stránok. Dáta, ktoré pavúk zhromaždí, sú odoslané späť vyhľadávaču, ktorý ich usporiada do obrovskej databázy nazývanej index. Keď niekto zadá vyhľadávací dopyt, vyhľadávač vytiahne relevantné výsledky z tohto indexu, nie z živého webu.
Termín “pavúk” pochádza zo spôsobu, akým tieto programy navigujú web: sledujú hypertextové odkazy zo stránky na stránku, podobne ako pavúk sa pohybuje po vláknach svojej siete. Prvým známym crawlerom bol WebCrawler, spustený v roku 1994, ktorý pomohol spopularizovať túto metaforu.
Google používa Googlebot, Bing používa Bingbot a oba sú pavúky vykonávajúce rovnakú základnú funkciu.

Nastavte pokročilé sledovanie za pár minút. Kreditná karta nie je potrebná.
Pochopenie procesu prehľadávania pomáha vlastníkom stránok robiť lepšie rozhodnutia o štruktúre stránky, priorite stránok a technickom SEO.
Každý pavúk začína so zoznamom známych webových adries nazývaných seed URL. Tie môžu pochádzať z predtým prehľadaných stránok, odoslaných XML sitemap alebo odkazov objavených počas skorších prehľadávaní. Z každého semena pavúk stiahne stránku a extrahuje všetky hypertextové odkazy, ktoré obsahuje. Tieto odkazy tvoria front — niekedy nazývaný crawl frontier — stránok na ďalšiu návštevu.
Keď pavúk dosiahne stránku, robí tri veci:
User-Agent hlavičky (napr. Googlebot/2.1).Proces prebieha v nepretržitej slučke:
Pavúk tiež pred prehľadávaním akejkoľvek stránky na doméne skontroluje súbor robots.txt. Ak súbor zakazuje určitú cestu, dobre vychovaný pavúk ju preskočí. Pavúky tiež dodržiavajú meta robots tagy a X-Robots-Tag HTTP hlavičky, ktoré im prikazujú neindexovať stránku alebo nesledovať jej odkazy.
Každý veľký vyhľadávač prevádzkuje svoj vlastný pavúk. Tu sú tie, ktoré s najväčšou pravdepodobnosťou navštívia vašu stránku:
| Názov pavúka | Vyhľadávač | User-Agent Token |
|---|---|---|
| Googlebot | Googlebot | |
| Bingbot | Bing | Bingbot |
| Slurp Bot | Yahoo (poháňaný Bingom) | Slurp |
| DuckDuckBot | DuckDuckGo | DuckDuckBot |
| Baiduspider | Baidu (Čína) | Baiduspider |
| Yandex Bot | Yandex (Rusko) | YandexBot |
| Applebot | Apple (Siri, Spotlight) | Applebot |
Googlebot existuje v dvoch variantoch: desktopový crawler, ktorý simuluje desktopový prehliadač, a mobilný crawler, ktorý simuluje smartfón. Odkedy Google prešiel na mobile-first indexovanie, mobilný Googlebot je primárnym crawlerom pre drvivú väčšinu stránok.
Bingbot poháňa Bing index a tiež poskytuje výsledky Yahoo a ďalším syndikačným partnerom. DuckDuckBot prehľadáva pre DuckDuckGo, ktorý dopĺňa svoj vlastný index výsledkami z Bingu. Baiduspider a Yandex Bot obsluhujú čínsky a ruský trh a stojí za to ich povoliť, ak máte publikum v týchto regiónoch.
Buďte prvý, kto sa dozvie o nových funkciách a aktualizáciách produktu.
Vyhľadávacie pavúky môžu vidieť všetko nasledujúce, keď navštívia stránku:
Pavúky nevidia stránky tak, ako ich vidí človek. Obsah vložený do obrázkov bez alt textu, text vykreslený v komplexnom JavaScripte, ktorý sa nespustí, a obsah za prihlasovacími stenami alebo paywallmi je pre väčšinu pavúkov neviditeľný. Interaktívne prvky ako formuláre, rozbaľovacie ponuky a obsah s nekonečným posúvaním, ktorý vyžaduje kliknutia používateľa, môžu byť tiež vynechané, pokiaľ stránka nepoužíva správne serverové vykresľovanie alebo techniky dynamického vykresľovania.
Crawl budget je počet stránok, ktoré vyhľadávací pavúk prehľadá na vašej stránke v rámci daného časového obdobia. Google určuje crawl budget na základe dvoch faktorov:
Pre veľké stránky — e-commerce katalógy, spravodajské portály alebo affiliate stránky s tisíckami produktových stránok — crawl budget záleží. Ak pavúky trávia čas na nízkohodnotných URL (filtrovacie parametre, session ID, duplicitné stránky), nemusia sa dostať k vášmu dôležitému obsahu pred zatvorením crawl okna.
Máte tri základné nástroje na usmerňovanie správania pavúkov.
Súbor robots.txt, umiestnený v koreňovom adresári vašej domény, hovorí pavúkom, ktoré časti vašej stránky môžu a nemôžu navštevovať. Používa jednoduchú syntax:
User-agent: *
Disallow: /admin/
Disallow: /search/
/admin/ a /search/. Môžete zacieliť konkrétne pavúky pomocou ich user-agent tokenu:User-agent: Googlebot
Disallow: /private/
Pre kontrolu na úrovni stránky použite meta robots tag v HTML <head>:
<meta name="robots" content="noindex, nofollow">
X-Robots-Tag), čo je užitočné pre ne-HTML súbory ako PDF.XML sitemapa obsahuje zoznam URL, ktoré chcete, aby pavúky uprednostnili. Odošlite ju cez Google Search Console alebo Bing Webmaster Tools. Sitemapa nezaručuje prehľadávanie, ale pomáha pavúkom rýchlejšie objavovať nové a aktualizované stránky — najmä na stránkach s hlbokou architektúrou alebo obmedzeným interným prepojením.
Termíny sú často zamieňané, ale opisujú rôzne účely:
| Aspekt | Web Crawler (Pavúk) | Web Scraper |
|---|---|---|
| Účel | Objavovať a indexovať stránky pre vyhľadávanie | Extrahovať špecifické dáta zo stránok |
| Prevádzkovateľ | Vyhľadávače (Google, Bing) | Jednotlivci, spoločnosti, výskumníci |
| Rozsah | Široký — celý dosiahnuteľný web | Cielený — konkrétne stránky alebo dátové body |
| Výstup | Vyhľadávateľný index | Štruktúrované dáta (CSV, databáza, API) |
| Rešpektuje robots.txt | Áno (legitímne) | Rôzne; mnohé scrapery ho ignorujú |
Pavúk vytvára mapu; scraper ťaží územie. Oba sú automatizované, ale slúžia zásadne odlišným cieľom. Niektoré nástroje, ako Screaming Frog SEO Spider, stierajú hranicu — prehľadávajú ako pavúk, ale používajú sa na audit stránok, nie na indexovanie vyhľadávačmi.
Nie inherentne. Legitímne vyhľadávacie pavúky sú prospešné — bez nich by sa vaša stránka nezobrazovala vo výsledkoch vyhľadávania. Nie všetky boty sú však priateľské.
Príznaky škodlivej bot aktivity zahŕňajú:
GPTBot od OpenAI je webový crawler používaný na zber tréningových dát pre AI modely. Nie je to vyhľadávací pavúk — nepoháňa verejný vyhľadávací index.
User-agent: GPTBot
Disallow: /
Ak vám záleží na súkromí, DuckDuckGo a Brave Search sú dva hlavné vyhľadávače, ktoré nesledujú používateľov ani nevytvárajú osobné profily. Oba prevádzkujú vlastné pavúky (DuckDuckBot a Brave crawler) a dopĺňajú svoje indexy výsledkami z iných zdrojov. Na hodnotenie výsledkov používajú kontextové kľúčové slová namiesto histórie používateľa, čo znamená, že on-page SEO vašej stránky je pre viditeľnosť na týchto platformách ešte dôležitejšie.
Vyhľadávacie pavúky priamo ovplyvňujú každú rolu v ekosystéme affiliate marketingu.
Vaše vstupné stránky affiliate programu, stránky s podmienkami a propagačný obsah musia byť prehľadávateľné a indexovateľné. Ak pavúky nemôžu dosiahnuť informácie o vašom programe, potenciálni affiliate partneri hľadajúci “affiliate program [vaša značka]” vás nemusia nájsť organicky. Kľúčové kroky:
Každá produktová recenzia, porovnávací článok a sprievodca, ktorý publikujete, závisí od nájdenia prostredníctvom vyhľadávania — a to znamená byť prehľadaný a indexovaný. Pavúky sú strážcovia brány. Osvedčené postupy:
lastmod vo vašej sitemape môže podnietiť pavúky, aby vaše stránky navštívili skôr.Pochopenie správania pavúkov vám pomôže lepšie podporovať vašich affiliate partnerov:
site: vyhľadávanie) a či neúmyselne neblokujú pavúky.Zistite, ako vám porozumenie webovým pavúkom môže pomôcť optimalizovať vašu stránku pre lepšie vyhľadávacie pozície a zvýšené affiliate príjmy.
Zistite, ako prehľadávače vyhľadávačov objavujú a indexujú webové stránky a prečo je to dôležité pre SEO.
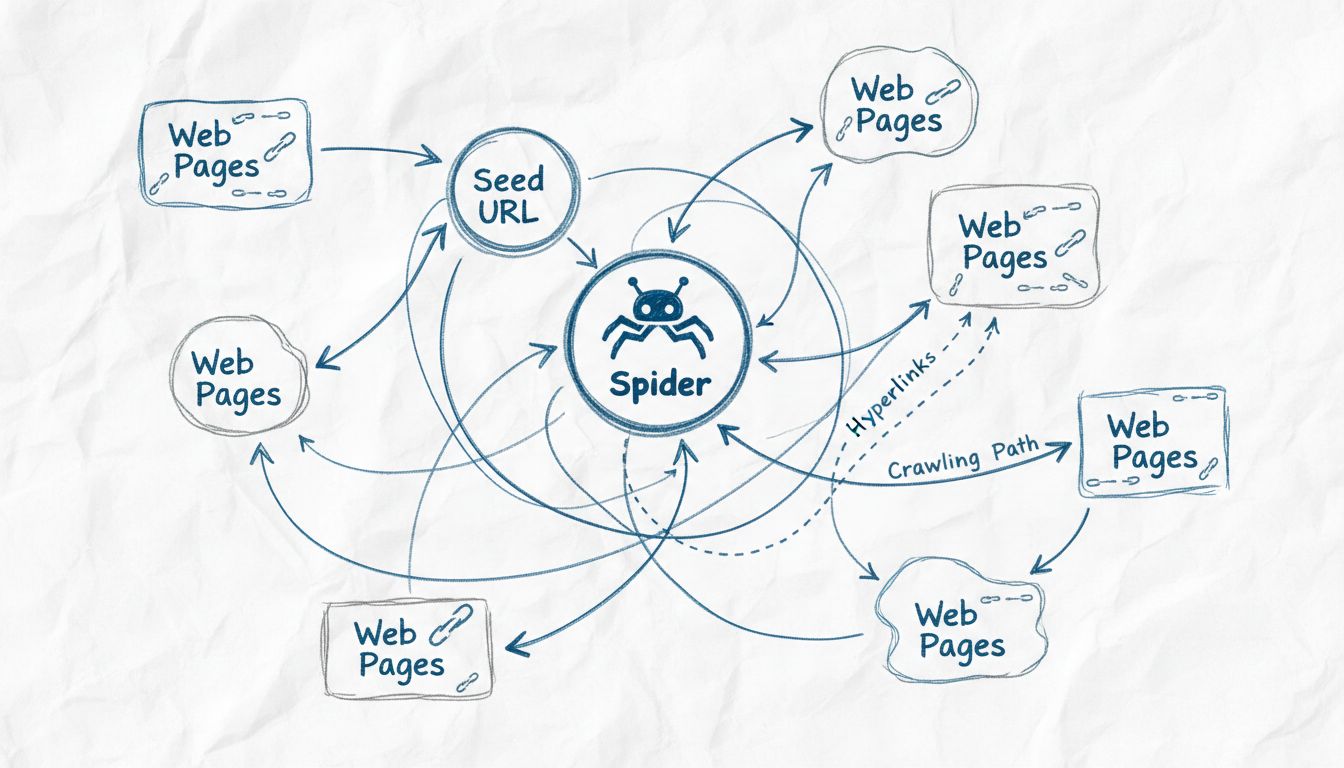
Zistite, prečo sa webové crawlery nazývajú pavúky, ako fungujú a akú kľúčovú úlohu zohrávajú pri indexovaní vyhľadávačmi. Objavte technické mechanizmy webového ...
Detekcia pavúkov identifikuje automatizované boty prehľadávajúce webové stránky, aby zabránila click fraudu, falošným leadom a skresleným analýzam v affiliate m...
Pridajte sa k našej komunite spokojných klientov a poskytujte vynikajúcu zákaznícku podporu s Post Affiliate Pro.


Súhlas s cookies
Používame cookies na vylepšenie vášho prehliadania a analýzu našej návštevnosti. See our privacy policy.